OpenCL (Open Computing Language) — это открытый стандарт для параллельных вычислений на гетерогенных платформах. Он позволяет разработчику писать один и тот же код, который будет исполняться на центральном процессоре (CPU), графическом процессоре (GPU), цифровых сигнальных процессорах (DSP) и даже на программируемых вентильных матрицах (FPGA). Стандарт разработан и поддерживается консорциумом Khronos Group, а не одной компанией, что обеспечивает его кроссплатформенность.
Программы и услуги по разработке программ на OpenCL востребованы в задачах, где важна производительность: обработка изображений и видео, научные расчёты, симуляции, а также в embedded-системах и на устройствах, где нет места проприетарным экосистемам. OpenCL поддерживает модели параллельного программирования данных (data parallelism) и задач (task parallelism), что позволяет эффективно загружать разные типы ускорителей.
Важно понимать статус OpenCL в 2026 году. Стандарт жив и развивается: актуальная версия — OpenCL 3.1, выпущенная Khronos Group. Однако в области машинного обучения и искусственного интеллекта OpenCL серьёзно потеснён экосистемой CUDA от NVIDIA, а для кроссплатформенных C++ проектов всё чаще выбирают SYCL [citation:6]. OpenCL остаётся сильным выбором для legacy-систем, embedded-устройств, мобильных платформ (Android) и задач, где важна совместимость со старым оборудованием, а не максимальная производительность на современных тензорных ядрах.
Как работает OpenCL
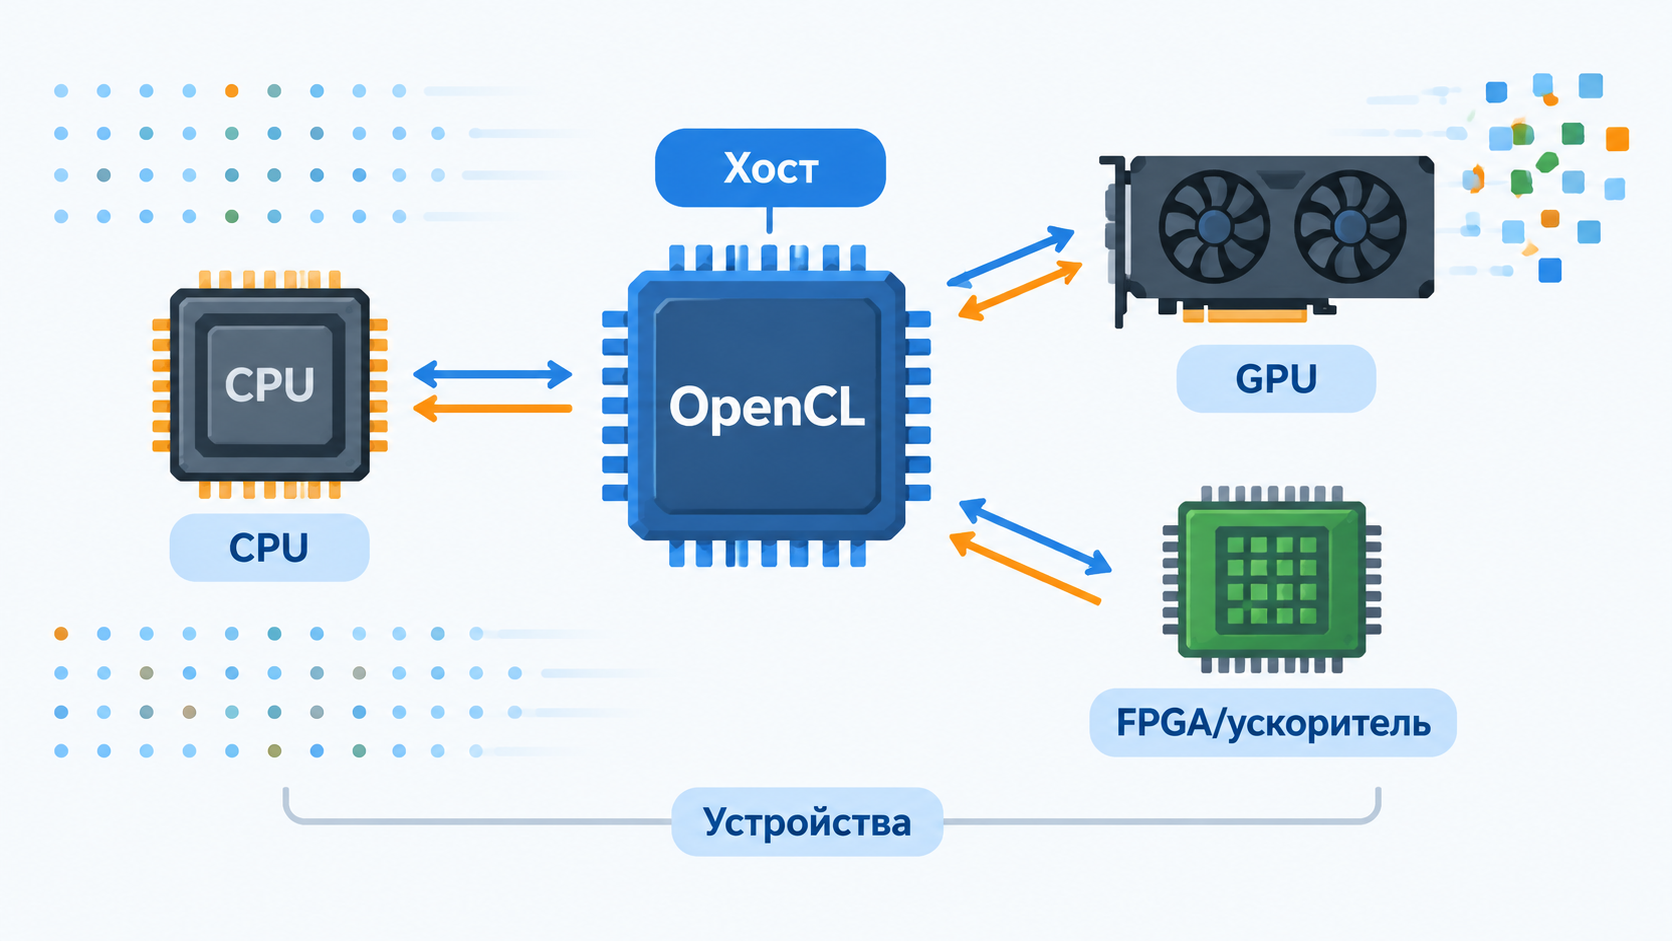
Архитектура OpenCL строится на взаимодействии хоста (host) и одного или нескольких устройств (devices). Хост — это основная программа, которая выполняется на CPU. Устройства — это ускорители (GPU, DSP, FPGA), которые выполняют вычисления. Хост управляет устройством через API: выделяет память, компилирует ядра (kernels), отправляет команды на выполнение и забирает результаты.
Схема ниже иллюстрирует этот принцип:

Программы для устройств пишутся на языке OpenCL C (основан на C99) или OpenCL C++ (основан на C++14 с ограничениями). Код компилируется в промежуточное представление SPIR-V, которое затем загружается на устройство. В отличие от CUDA, где компилятор жёстко привязан к GPU NVIDIA, OpenCL-компиляторы существуют для CPU (Intel, AMD), GPU (AMD, Intel, NVIDIA) и специализированных ускорителей. В 2026 году также активно развиваются слоистые реализации (layered implementations), например clspv + clvk, которые транслируют OpenCL-код в Vulkan и позволяют запускать его на устройствах, где нет нативного драйвера OpenCL.
Как запустить программу с использованием OpenCL? Хост-программа (написанная, например, на C или C++) использует OpenCL API для:
- идентификации доступных устройств (GPU, CPU);
- компиляции ядер (программ для устройств);
- выделения памяти на устройстве и копирования туда данных;
- постановки ядер в очередь на выполнение;
- чтения результатов обратно в память хоста.
OpenCL код: хост и ядро
Типичная OpenCL-программа состоит из двух частей. Хост-код выполняется на CPU и управляет всем процессом. Ядро (kernel) — это функция, которая выполняется на устройстве параллельно для каждого элемента данных.
Упрощённая последовательность действий в хост-коде:
- Инициализация OpenCL: выбор платформы и устройства.
- Создание контекста (context) и очереди команд (command queue).
- Загрузка и компиляция программы с ядром.
- Создание буферов памяти на устройстве и копирование в них исходных данных.
- Установка аргументов ядра (указатели на буферы, размеры).
- Постановка ядра в очередь с указанием глобального и локального размера задачи (NDRange).
- Ожидание завершения и чтение результатов обратно в память хоста.
Пример псевдокода ядра для параллельного суммирования двух векторов:
__kernel void vectorAdd(__global const float* a,
                       __global const float* b,
                       __global float* c)
{
    int i = get_global_id(0);
    c[i] = a[i] + b[i];
}
Каждый «поток» (work-item) получает свой индекс `i` и выполняет сложение независимо от остальных. Именно в этом и заключается параллелизм: тысячи таких операций могут выполняться на GPU одновременно.
Параллельная обработка: в чём выигрыш
Рассмотрим ту же задачу — сложение двух векторов — на обычном последовательном коде (например, на C#):
for (int i = 0; i < n; i++) {
    c[i] = a[i] + b[i];
}
Цикл выполняется итерация за итерацией: сначала вычисляется `c[0]`, потом `c[1]` и так далее. На CPU это происходит очень быстро, но всё равно последовательно.
В OpenCL-версии мы описываем только операцию для одного элемента, а среда выполнения сама создаёт тысячи параллельных экземпляров ядра. Каждый экземпляр работает со своим индексом. Результат — тот же массив `c`, но заполненный параллельно на всех доступных вычислительных блоках GPU.
Важное ограничение: такой параллелизм возможен только тогда, когда элементы результата независимы друг от друга. В примере с векторами `c[i]` зависит только от `a[i]` и `b[i]`, поэтому распараллеливание корректно. Если бы каждый следующий элемент зависел от предыдущего (например, в последовательном накоплении суммы), простой параллельный вариант не сработал бы.
Сравнение: обычный код и OpenCL
Следующая таблица показывает различия не как «плохо/хорошо», а как разные инструменты для разных задач.
| Аспект | Обычный последовательный код (CPU) | OpenCL |
|---|---|---|
| Модель исполнения | Обычно один поток, инструкции выполняются друг за другом | Тысячи параллельных потоков (work-items), сгруппированных в work-groups |
| Аппаратное ускорение | Только SIMD-инструкции CPU | GPU, DSP, FPGA и другие ускорители |
| Использование всех устройств в системе | Как правило, только CPU | Да, можно выбрать любое доступное устройство |
| Сложность разработки | Низкая для последовательных алгоритмов | Выше: нужно явно управлять памятью, размерами задач и синхронизацией |
| Переносимость между вендорами | Высокая (код на C/C++/C# работает везде) | Высокая на уровне API, но производительность зависит от драйверов и архитектуры |
| Поддержка в 2026 году | Универсальная | Живая, но в ML-сегменте уступает CUDA и SYCL; сильна в embedded и legacy |
OpenCL — это мощный инструмент для ускорения вычислительных задач, которые хорошо распараллеливаются: обработка изображений, матричные операции, физические симуляции, кодирование видео. Он остаётся важной частью гетерогенных вычислений, особенно там, где нужна кроссплатформенность и поддержка старого оборудования. Однако для новых проектов в области машинного обучения стоит серьёзно оценить CUDA (если стек полностью на NVIDIA) или SYCL (если нужна кроссплатформенность C++ с современным подходом). OpenCL — это осознанный выбор в пользу совместимости, а не ставка на максимальную производительность в AI-задачах.
OpenCL — это мощный инструмент для ускорения вычислительных задач, таких как математические расчеты, обработка изображений, кодирование видео и многое другое. Он поддерживает модели параллельного программирования данных и параллельного программирования задач, что позволяет разработчикам легко использовать возможности различных типов аппаратного обеспечения. Ожидается, что OpenCL будет становиться все более популярным в ближайшем будущем, поскольку он предлагает удивительные преимущества производительности для инженеров и ученых. Однако OpenCL подходит не для всех приложений, поскольку он может не обеспечить преимущества в производительности для задач веб-разработки.
Параллельная обработка данных известна давно. Например язык пролог, так же использует параллельную обработку данных, только написание программы на нем более «сложна», для тех кто привык писать программу последовательно. А OpenCL я так поняла выход из этой ситуации. Программа пишется традиционно-последовательно, но осуществляет параллельную обработку данных. Ну и плюс его, язык современный, много дополнительных функций.
Я аплодирую стоя, удивлен такими знаниями девушки.
Программирование с OpenCL было бы еще проще, если бы производители железа поменьше экспериментировали с этим движком, ну хотя бы с его визуальным представлением: а то у NVIDIA — это Cuda, у AMD — это ATI Stream, только на Mac OS X Snow Leopard OpenCL в чистом виде представлен, встроенным в ось. Просто пользователь иногда даже и не знает, что у него на компьютере уже все установлено вместе с драйверами, а потом тратит много времени на поиски спец. ПО для разработки (например, Cuda Toolkit).
Однозначно лучшая статья которую я читал о языке параллельных вычислений OpenCL. Даже наверное самая уникальная и информативная, написана доступным и понятным языком, любопытна будет как профессионалам так и любителям.